← All publications

TODAES 2026

RL-MUL 2.0: Multiplier Design Optimization with Parallel Deep Reinforcement Learning and Space Reduction

Dongsheng Zuo*, Jiadong Zhu*, Yikang Ouyang, Yuzhe Ma

Asterisk: Equal contribution.

ACM Transactions on Design Automation of Electronic Systems (TODAES), 31(4), 1–20 (2026)
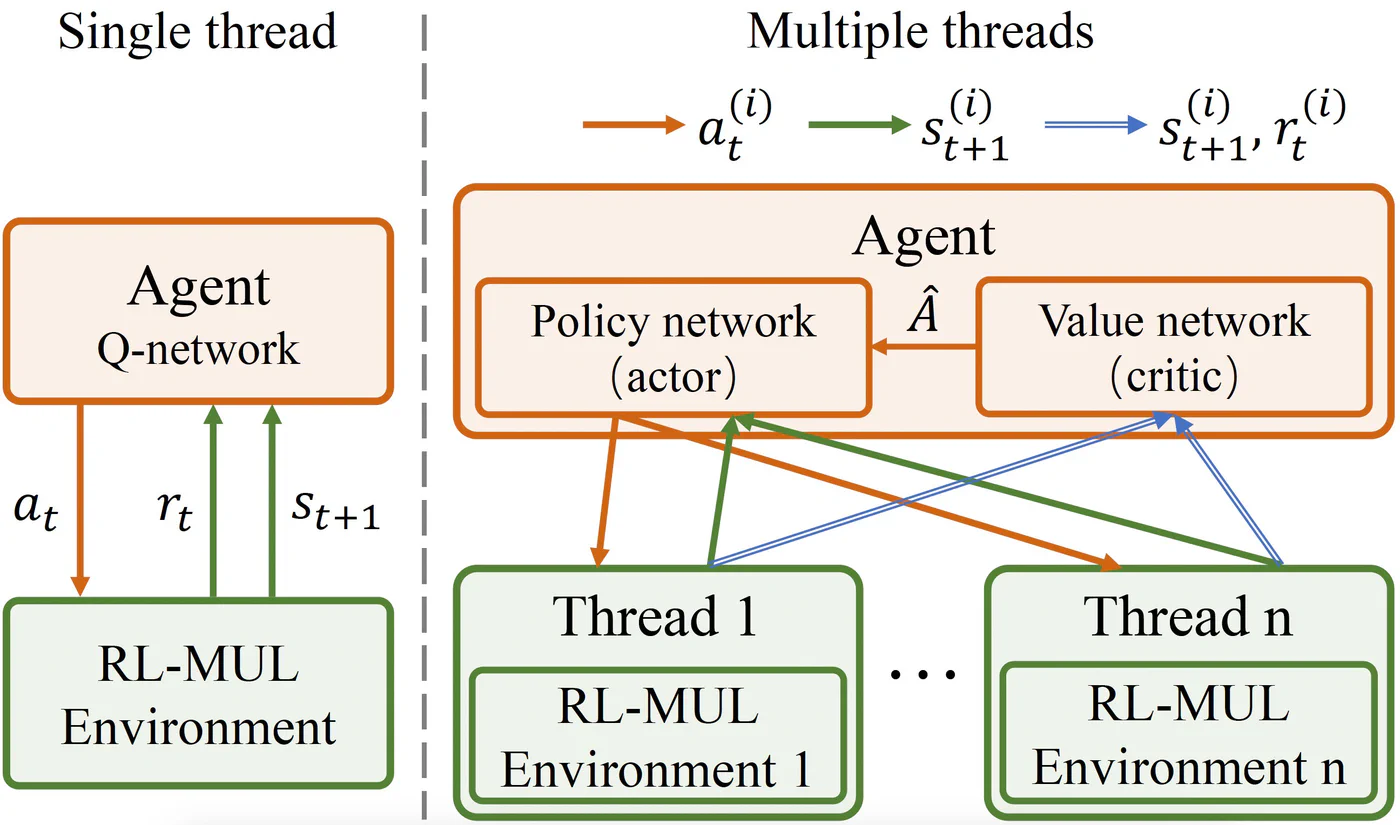
RL-MUL 2.0 learning architecture: single-thread Q-learning is extended to a shared actor-critic agent interacting with multiple multiplier-design environments in parallel (Figure 5).
DatapathOptimizationMultiply Accumulate

CITATION

BibTeX